
Wissenschaftlich nutzbarer Katalog für historische Manuskripte
Historische Manuskripte werden als wissenschaftlicher Katalog mit präzisen Metadaten, differenzierten Filtern und Kontext erschlossen.

Herausforderung
Ein großer internationaler Bestand historischer Manuskripte lässt sich nicht über einfache Volltextsuche erschließen. Jedes Dokument benötigt differenzierte wissenschaftliche Beschreibungen, Datierung, Herkunft, Material, Bildmaterial und weitere fachliche Merkmale. Forschende, Lehrende und Sammler erwarten präzise Filter und stabile Zusammenhänge, während Neuangebote, Archivobjekte, Videos und Bildungsinhalte redaktionell handhabbar bleiben müssen. Die Materialität der Originale sollte trotz komplexer Daten hochwertig sichtbar werden.
Lösung
Die Manuskripte wurden als umfangreich beschriebene, mehrsprachige Objekte in einem wissenschaftlich nutzbaren Katalog modelliert. Kombinierbare Filter ermöglichen gezielte Recherchen auch in großen Beständen; Werkdetailseiten verbinden Metadaten mit hochwertigen Ansichten. Neuangebote und bereits verkaufte Archivstücke bleiben dauerhaft auffindbar. Ergänzende Videos, Newsletter und Bildungsangebote schaffen unterschiedliche Zugänge, ohne den fachlichen Kern zu verwässern. So verbindet der Auftritt Forschung, Vermittlung und Markt in einer konsistenten Struktur.
Struktur und Funktionen des Projekts
Technische Ausgangslage
Sehr viele Manuskripte mit umfangreichen, teils spezialisierten Metadaten mussten performant recherchierbar und mehrsprachig pflegbar sein. Zahlreiche Filter sollten kombinierbar bleiben und dennoch verständliche Ergebnisse liefern. Zusätzlich waren aktuelle Angebote, ein langfristiges Verkaufsarchiv, Bildmaterial und ergänzende redaktionelle Inhalte miteinander zu verknüpfen.
Umsetzung
Manuskripte wurden als strukturierte Objekte mit normalisierten Beschreibungs-, Datierungs-, Herkunfts- und Klassifikationsfeldern angelegt. Der Suchindex und facettierte Filter greifen auf diese Merkmale zu und erlauben auch bei großen Beständen präzise Kombinationen. Statusangaben trennen Neuangebote und Archiv, ohne Datensätze oder wissenschaftliche Informationen zu verlieren. Relationen binden Manuskripte an Videos, Bildungsinhalte und weitere redaktionelle Kontexte. Mehrsprachige Felder und wiederverwendbare Ausgabekomponenten sorgen dafür, dass Redaktion, Recherche und hochwertige Bildpräsentation auf derselben Datenbasis aufbauen.
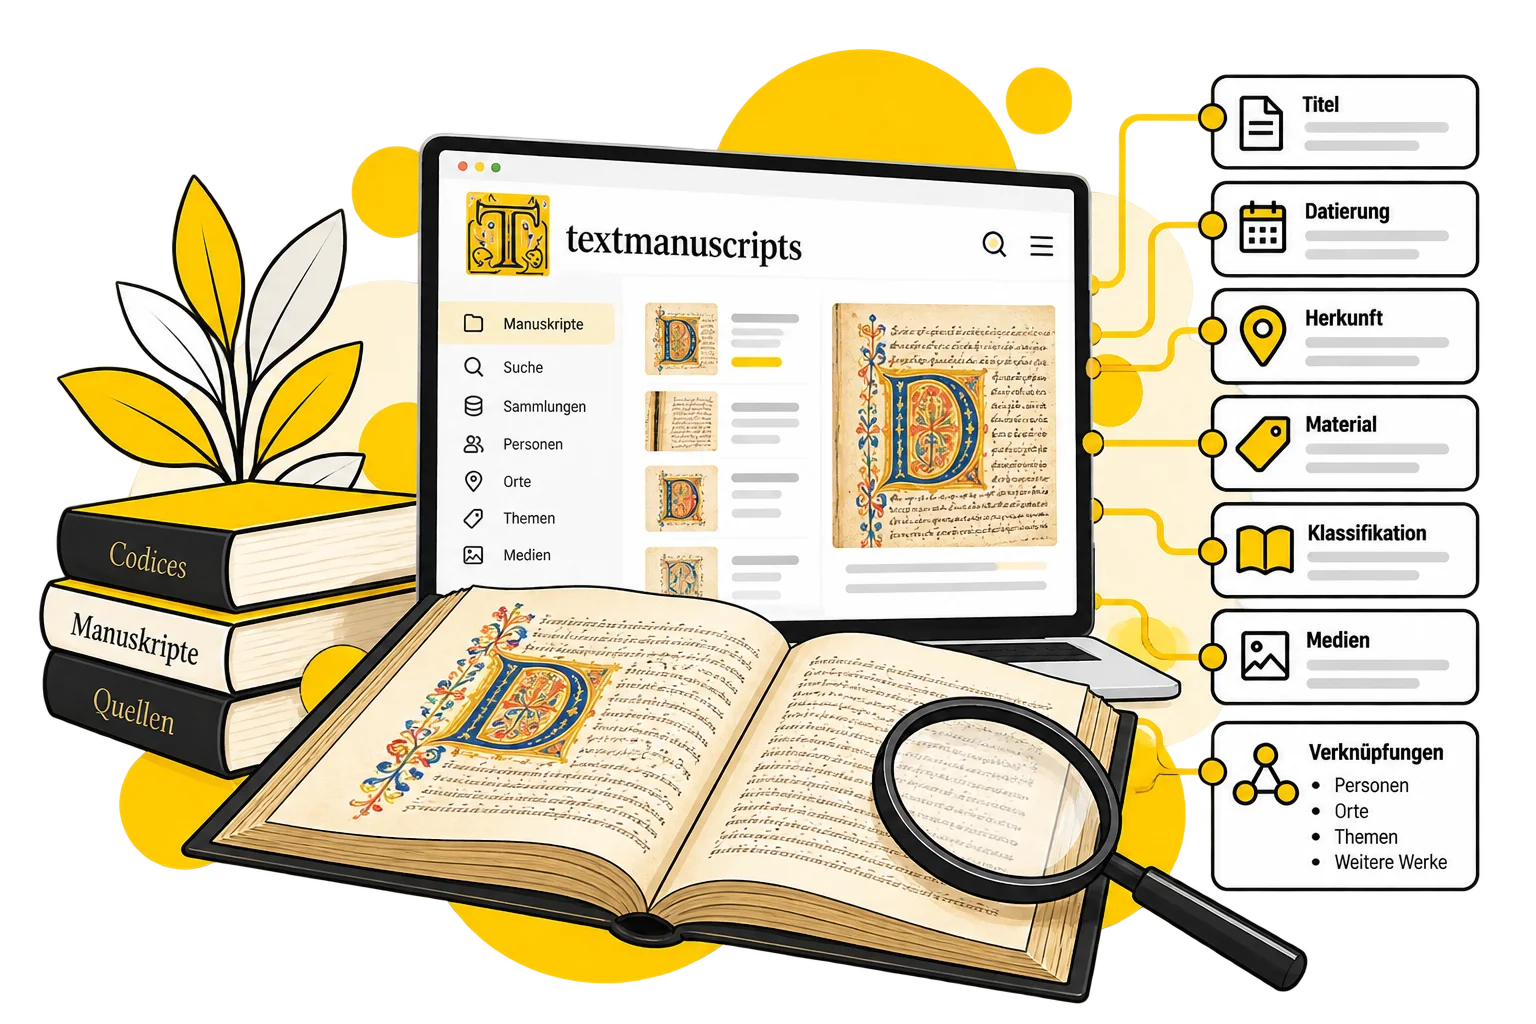
Strukturierte Metadaten zentral verwalten
Bei Textmanuscripts werden historische Manuskripte nicht als einzelne Webseiten, sondern als strukturierte Datenobjekte verwaltet. Zu jedem Manuskript gehören unter anderem Beschreibung, Datierung, Herkunft, Klassifikation und weitere wissenschaftliche Merkmale.
Diese Informationen werden zentral gepflegt und bilden die Grundlage für unterschiedliche Ansichten und Recherchemöglichkeiten. Kombinierbare Filter greifen direkt auf die strukturierten Merkmale zu und ermöglichen auch bei einem umfangreichen Bestand eine gezielte Suche.
Das Projekt zeigt, dass zentrale Datenverwaltung nicht auf klassische Produktinformationen beschränkt ist: Auch komplexe wissenschaftliche Inhalte lassen sich strukturiert erfassen, miteinander verknüpfen und flexibel ausgeben.
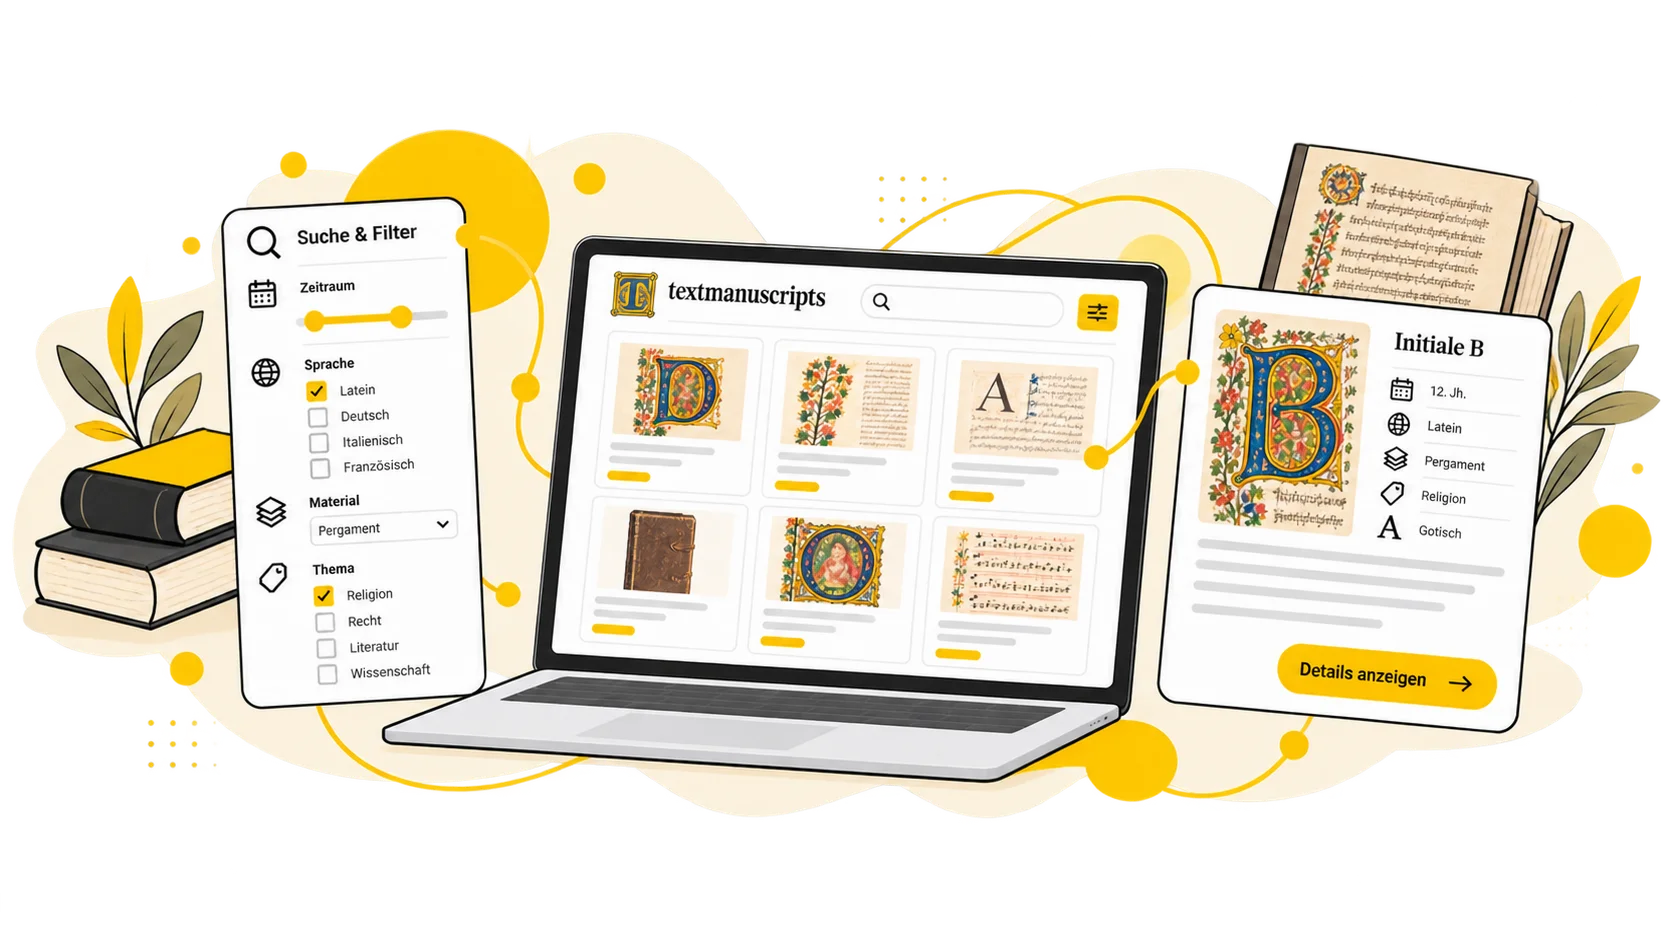
Komplexe Bestände gezielt durchsuchbar machen
Eine einfache Volltextsuche reicht für einen wissenschaftlichen Manuskriptbestand nicht aus. Deshalb wurde die Recherche bei Textmanuscripts direkt auf die strukturierten Eigenschaften der einzelnen Manuskripte aufgebaut.
Nutzer können unterschiedliche Kriterien wie Datierung, Herkunft oder Klassifikation miteinander kombinieren und den Bestand dadurch schrittweise eingrenzen. Die Filter greifen dabei auf dieselben Daten zurück, die auch für Übersichten und Detailseiten verwendet werden.
So wird aus einem umfangreichen Datenbestand eine Webanwendung, in der wissenschaftlich relevante Informationen gezielt recherchiert werden können, ohne die redaktionelle Pflege unnötig zu vervielfachen.

Komplexe Inhalte als Datenmodell abbilden
Textmanuscripts stellt hohe Anforderungen an die Struktur der verwalteten Inhalte. Manuskripte besitzen zahlreiche wissenschaftliche Merkmale, mehrsprachige Felder, Medien und Beziehungen zu weiteren Inhalten.
Das Datenmodell bildet diese Informationen strukturiert ab, anstatt sie in einzelnen Seiten fest miteinander zu verbinden. Dadurch können dieselben Daten für Such- und Filterfunktionen, Übersichten und detaillierte Werkansichten verwendet werden.
Gleichzeitig lassen sich Manuskripte mit Videos, Bildungsangeboten und weiteren redaktionellen Inhalten verknüpfen. So entsteht eine technische Grundlage, auf der wissenschaftliche Daten und redaktionelle Inhalte gemeinsam weiterentwickelt werden können.
